E se fosse possível ter uma inteligência artificial dentro de um simples pendrive, que funcionasse sem Internet e sem pagar qualquer subscrição? Parece algo complicado, mas atualmente já existem soluções que permitem fazer exatamente isso.
Neste artigo, vou apresentar o llamafile, um projeto que permite executar modelos de inteligência artificial localmente, diretamente no computador. Além disso, vou mostrar como podemos transportar estes ficheiros num pendrive e utilizar a nossa própria IA mesmo quando não temos acesso à Internet.
Mas será que esta solução funciona bem na prática? E será que um modelo de inteligência artificial executado localmente consegue oferecer respostas úteis sem depender de serviços online?
Para descobrir, fiz alguns testes com o modelo Qwen3.5-0.8B-Q8_0 em algumas tarefas mais simples e outras um pouco mais técnicas. Os resultados foram interessantes, embora também tenha encontrado algumas limitações.
O que é o llamafile e como funciona?
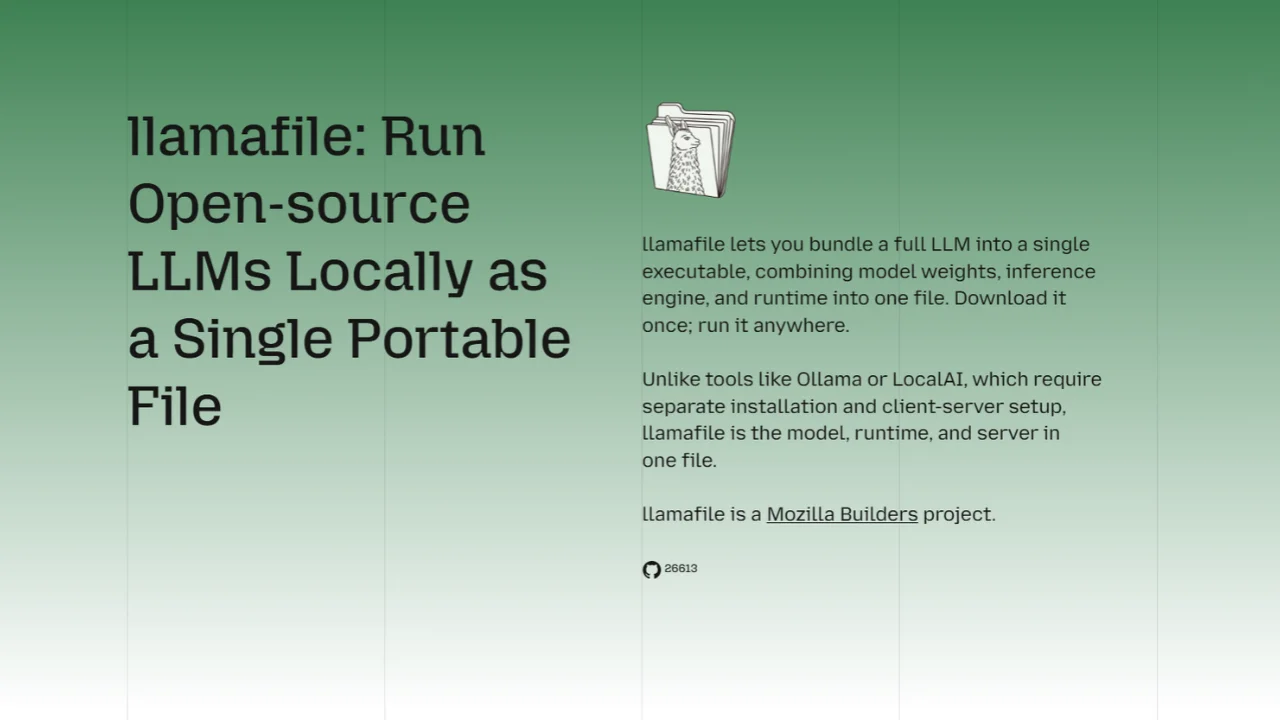
O llamafile é um projeto open source associado à Mozilla que permite distribuir e executar modelos de inteligência artificial através de um único ficheiro executável. A grande vantagem desta solução é que não precisamos de instalar uma plataforma complexa nem de depender de um serviço online para conversar com a IA. Em vez disso, o modelo é executado diretamente no nosso computador, utilizando os recursos de hardware disponíveis.
Na prática, o llamafile combina o necessário para executar um modelo de IA num único ficheiro. Desta forma, podemos descarregá-lo, guardá-lo num pendrive e executá-lo num computador compatível.
Além disso, como o processamento acontece localmente, as perguntas e os dados utilizados podem permanecer no próprio equipamento, sem serem enviados para servidores externos. Isto representa uma vantagem interessante em termos de privacidade, desde que não sejam utilizadas integrações ou serviços externos que transmitam informação para a Internet.
Outra vantagem é a possibilidade de utilizar a inteligência artificial mesmo sem ligação à Internet. Depois de descarregarmos os ficheiros necessários, podemos desligar a ligação de rede e continuar a utilizar o modelo normalmente.
Podes consultar o projeto e a documentação oficial aqui: llamafile – Projeto oficial no GitHub
Como utilizar uma IA num pendrive?
Uma das características mais interessantes do llamafile é a simplicidade de utilização. No entanto, existem algumas diferenças dependendo do sistema operativo. Para os meus testes, utilizei o modelo Qwen3.5-0.8B-Q8_0, disponibilizado pela própria equipa do projeto.
Este modelo tem aproximadamente 1,77 GB e é uma das opções mais pequenas disponíveis nesta versão do llamafile. Por esse motivo, é uma escolha interessante para experimentar inteligência artificial localmente, sobretudo em computadores com recursos mais limitados.
No Windows, o processo é relativamente simples. Depois de descarregarmos o ficheiro, precisamos apenas de alterar a extensão para .exe e colocá-lo no pendrive. A partir daí, basta executar o ficheiro para iniciar o processo. O llamafile abre uma janela de terminal e disponibiliza uma interface que podemos aceder através do navegador, utilizando um endereço local.
Já no Linux, macOS e BSD, existem alguns passos adicionais relacionados com as permissões de execução. No Linux, por exemplo, podemos utilizar o comando chmod +x para permitir a execução do ficheiro.
É importante salientar que, embora possamos transportar a IA num pendrive, isso não significa que funcione automaticamente em qualquer computador. O equipamento precisa de ser compatível e ter recursos suficientes para executar o modelo escolhido.
Existe ainda uma particularidade importante no Windows: os executáveis não podem ultrapassar os 4 GB. Por isso, se escolhermos modelos maiores, teremos de utilizar o executável do llamafile separadamente dos pesos do modelo, recorrendo a ficheiros externos.
Testei a IA sem Internet: primeiros resultados
Depois de preparar o pendrive, chegou o momento de testar a inteligência artificial. Antes de começar, desliguei completamente a ligação à Internet para confirmar se o modelo continuava a funcionar sem qualquer dependência de serviços online.
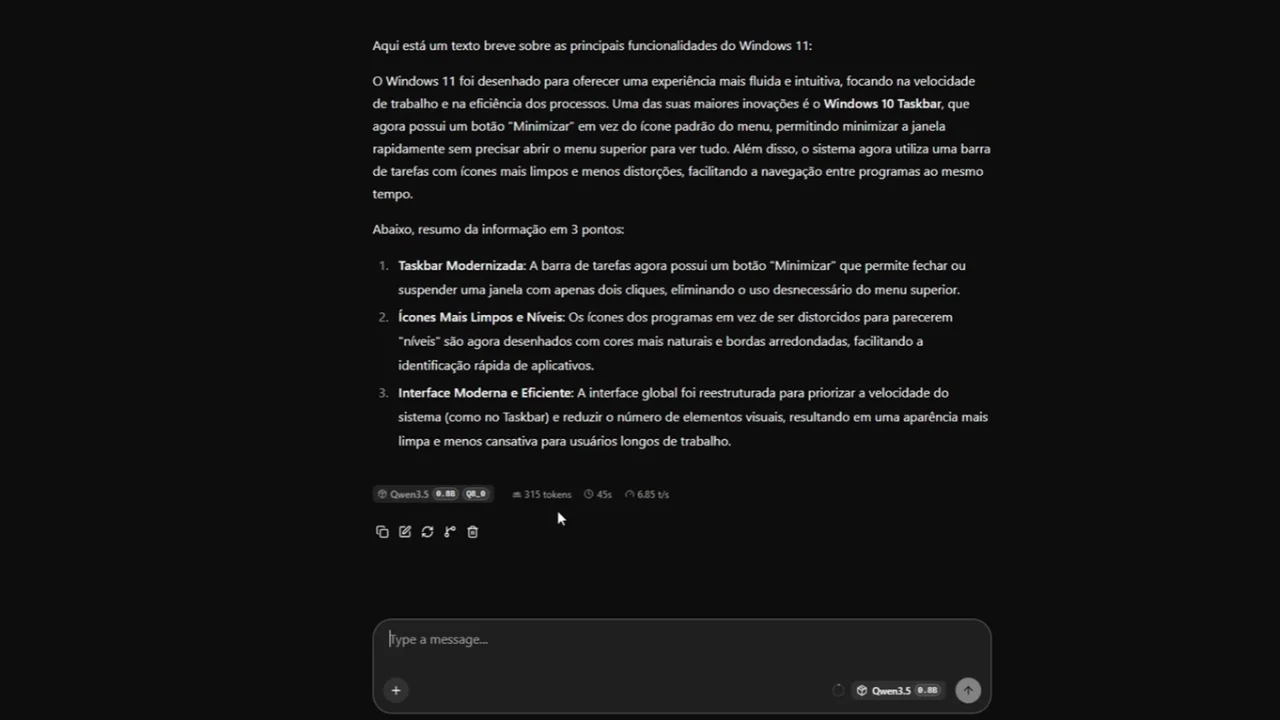
E a primeira experiência foi positiva. Comecei por pedir ao Qwen3.5-0.8B-Q8_0 que escrevesse um pequeno texto sobre cinco funcionalidades úteis do Windows 11 e, posteriormente, resumisse a informação em três pontos. Durante a geração da resposta, o modelo apresentou uma velocidade relativamente interessante, tendo gerado aproximadamente 315 tokens em 45 segundos.
Embora não seja uma velocidade particularmente elevada quando comparada com algumas soluções de IA online, é importante recordar que todo o processamento estava a acontecer localmente. Além disso, não estava a utilizar qualquer serviço na nuvem para gerar a resposta.
Este primeiro teste demonstrou que é perfeitamente possível utilizar uma IA diretamente a partir de um pendrive, mesmo sem ligação à Internet, para realizar tarefas relativamente simples.
Segundo teste: será que consegue gerar código PowerShell?
Depois do primeiro teste, decidi experimentar algo um pouco mais exigente. Desta vez, pedi ao modelo que criasse um script PowerShell capaz de apresentar o nome do computador, a versão do Windows e a quantidade de memória RAM instalada. Além disso, solicitei uma breve explicação sobre o funcionamento do código.
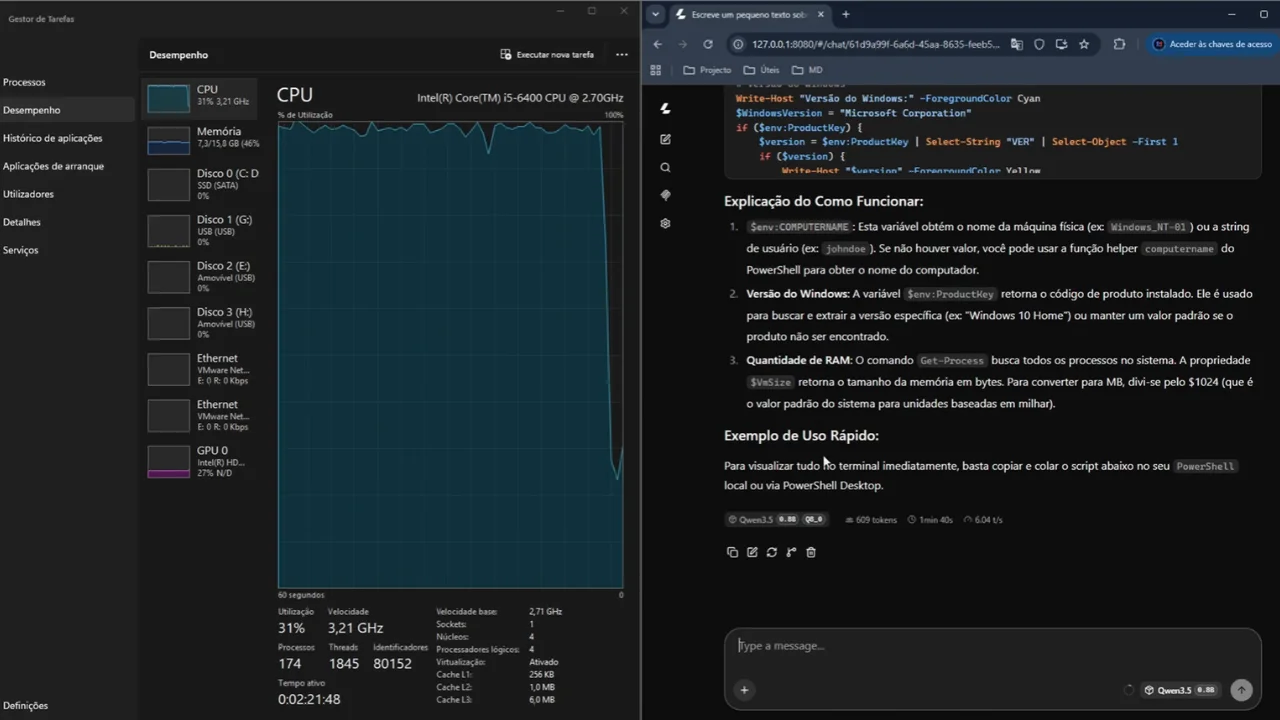
Para acompanhar o comportamento do computador, abri também o Gestor de Tarefas e coloquei-o lado a lado com a interface da inteligência artificial. Antes de iniciar a geração, o computador já apresentava um consumo de memória RAM de aproximadamente 7,1 GB e uma utilização do processador entre 20% e 30%.
No entanto, assim que comecei a gerar a resposta, a utilização do processador disparou para valores próximos dos 100%. Quanto à memória RAM, o consumo passou de aproximadamente 7,1 GB para 7,2 GB. No final, o modelo conseguiu gerar cerca de 609 tokens, demorando aproximadamente 1 minuto e 40 segundos para apresentar o script e a respetiva explicação.
Contudo, ainda faltava verificar se o código realmente funcionava. Copiei o script gerado para um ficheiro PowerShell e tentei executá-lo. Porém, a primeira tentativa não foi bem-sucedida. Naturalmente, poderia pedir à própria inteligência artificial que analisasse o problema e corrigisse o código. No entanto, optei por não continuar a corrigir o resultado, uma vez que o objetivo deste teste era avaliar a capacidade inicial do modelo.
Este resultado demonstra uma das limitações que devemos ter em consideração: apesar de conseguir gerar código e apresentar explicações, um modelo pequeno nem sempre consegue produzir resultados corretos à primeira tentativa. Por isso, é importante verificar sempre o código gerado antes de o executar.
O desempenho depende do modelo e do computador
Uma das questões mais importantes quando falamos de inteligência artificial local é o desempenho. Ao contrário de serviços online, nos quais grande parte do processamento acontece em servidores externos, neste caso é o nosso próprio computador que tem de executar o modelo.
Consequentemente, a velocidade das respostas depende diretamente das capacidades do equipamento, nomeadamente do processador, da memória RAM e, quando suportada e utilizada, da placa gráfica. Além disso, o modelo escolhido também tem uma influência significativa.
Os modelos mais pequenos, como o Qwen3.5-0.8B-Q8_0 que utilizei nos testes, apresentam a vantagem de ocupar menos espaço e exigir menos recursos do computador. No entanto, também podem apresentar maiores limitações na compreensão de instruções complexas, na análise de informação e na geração de código mais elaborado.
Por outro lado, os modelos maiores tendem a oferecer respostas mais completas e melhores resultados em determinadas tarefas exigentes. Ainda assim, necessitam geralmente de mais memória e capacidade de processamento, podendo também tornar a geração das respostas mais lenta.
É importante perceber que um modelo maior não significa automaticamente que seja melhor em todas as situações. A qualidade depende também da arquitetura do modelo, da tarefa solicitada e da forma como está configurado.
Portanto, se os resultados não forem tão bons como esperavas, isso não significa necessariamente que o llamafile tenha algum problema. Pode simplesmente ser uma limitação do modelo escolhido.
Vantagens e desvantagens de utilizar uma IA no pendrive
Depois de experimentar esta solução, existem algumas vantagens que considero particularmente interessantes.
Principais vantagens:
Funciona sem Internet: depois de descarregar os ficheiros necessários, podemos utilizar a IA mesmo sem ligação à rede.
Maior controlo sobre os dados: como o processamento é local, as nossas conversas podem permanecer no computador, desde que não sejam utilizados serviços externos.
Portabilidade: podemos transportar os ficheiros num pendrive e utilizá-los noutros computadores compatíveis.
Sem subscrições: o projeto e o modelo utilizados estão disponíveis gratuitamente, embora seja necessário ter em conta os custos de hardware e armazenamento.
Open source: o projeto disponibiliza o seu código e permite que a comunidade o consulte e contribua para o seu desenvolvimento.
Naturalmente, também existem algumas desvantagens.
Principais limitações:
Dependência do hardware: o desempenho está diretamente relacionado com os recursos do computador.
Respostas mais lentas: em equipamentos menos potentes, a geração de texto pode demorar bastante.
Modelos com limitações: as versões mais pequenas podem apresentar dificuldades em tarefas complexas.
Espaço de armazenamento: os modelos maiores podem ocupar vários gigabytes, exigindo pendrives com capacidade suficiente.
Compatibilidade: nem todos os ficheiros executáveis e modelos funcionam da mesma forma em todos os sistemas operativos e equipamentos.
Assim, apesar de ser uma solução bastante interessante, não devemos esperar que um modelo pequeno executado num computador comum tenha o mesmo desempenho de uma IA online suportada por servidores de elevada capacidade.
Vale a pena utilizar uma inteligência artificial no pendrive?
Na minha opinião, o llamafile é um projeto bastante interessante, principalmente para quem procura experimentar inteligência artificial localmente, sem depender da Internet e sem estar limitado a subscrições mensais.
A possibilidade de transportar um modelo de IA num simples pendrive e utilizá-lo noutros computadores é, sem dúvida, uma das características mais interessantes desta solução. Além disso, a execução local representa uma vantagem para quem valoriza a privacidade e pretende ter maior controlo sobre os seus dados.
Contudo, os meus testes também demonstraram algumas limitações. O modelo Qwen3.5-0.8B-Q8_0 conseguiu responder a perguntas simples e gerar código PowerShell, mas apresentou dificuldades no segundo teste e exigiu bastante processamento do computador. Por isso, considero que esta solução é particularmente interessante para tarefas simples, experiências com IA e situações em que não temos acesso à Internet.
Se pretendes utilizar a inteligência artificial para programação mais exigente, análise de informação ou outras tarefas complexas, poderá fazer sentido experimentar modelos maiores e mais capazes, desde que o teu computador tenha recursos suficientes. No final, tudo depende daquilo que pretendes fazer e do equipamento que tens disponível.
E tu, já experimentaste utilizar uma inteligência artificial localmente? Achas que esta possibilidade de transportar uma IA num pendrive pode ser útil no teu dia a dia? Deixa a tua opinião nos comentários!